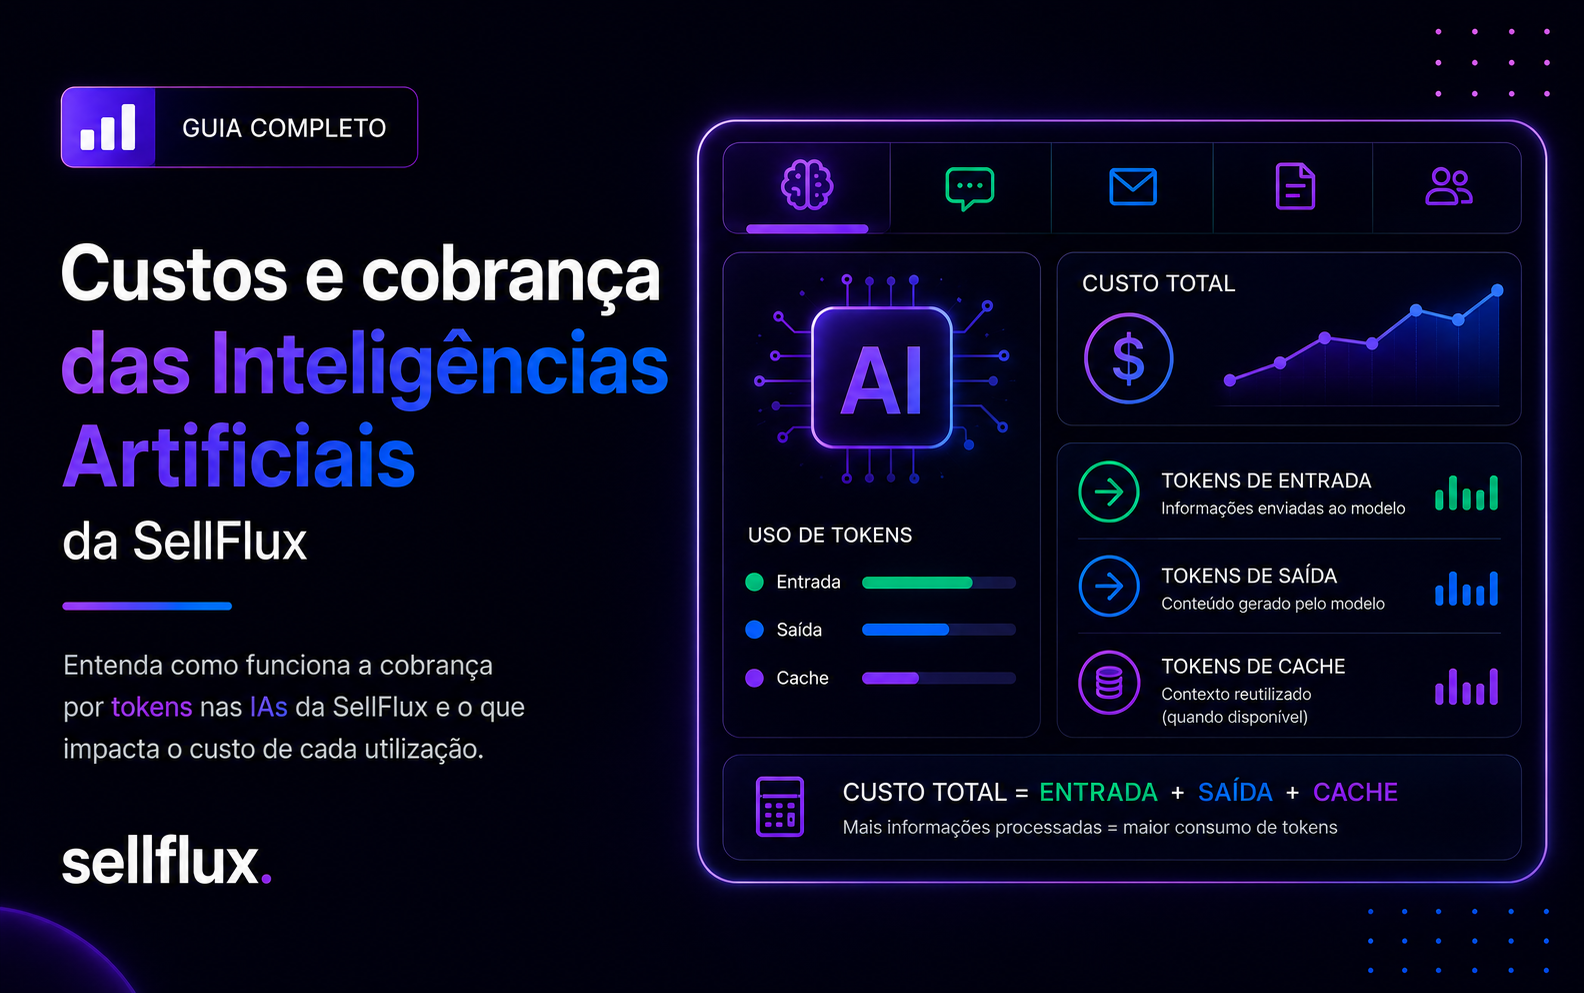
O custo de cada utilização depende principalmente de:
- Modelo de IA utilizado;
- Tokens de entrada, que correspondem às informações enviadas ao modelo;
- Tokens de saída, que correspondem ao conteúdo gerado pelo modelo;
- Tokens de cache, quando o modelo utilizado oferece esse recurso.
Importante: não existe um valor fixo por utilização de uma funcionalidade. O custo varia conforme a quantidade de informações processadas e o modelo selecionado.
Como funciona a cobrança por tokens?
Tokens de entrada
São todas as informações enviadas para o modelo para que ele consiga compreender a solicitação e executar a tarefa.
Dependendo da funcionalidade, podem incluir:
- Mensagens;
- Histórico de conversas;
- Prompts e instruções;
- Documentos;
- Dados de leads;
- Etc.;
Tokens de saída
São os tokens correspondentes ao conteúdo produzido pela Inteligência Artificial.
Podem representar:
- Respostas;
- Textos;
- Copies;
- Análises;
- Códigos;
- Etc.
Quanto maior e mais detalhada for a resposta gerada, maior poderá ser o consumo de tokens de saída.
Tokens de cache
Alguns modelos permitem armazenar e reutilizar parte das informações enviadas anteriormente.
Quando esse recurso está disponível, os tokens reutilizados podem ser cobrados por uma tarifa de cache, normalmente diferente e inferior à tarifa dos tokens de entrada.
IA de Atendimento
A IA de Atendimento utiliza tokens durante o processamento das conversas para compreender as mensagens do cliente, consultar o contexto disponível e gerar uma resposta adequada.
O que pode ser considerado na entrada?
Mensagem enviada pelo cliente;
Histórico da conversa;
Instruções do agente;
Regras configuradas;
Informações do lead;
Produtos;
Outros dados utilizados no contexto do atendimento.
O que é considerado na saída?
São contabilizados os tokens utilizados para gerar a resposta enviada pela IA ao cliente.
Exemplo:
Imagine que um cliente envie:
"Quero saber se vocês têm o plano profissional e quanto ele custa."
Para responder, a IA pode precisar processar:
- A mensagem do cliente;
- O histórico da conversa;
- As instruções do agente;
- As informações sobre os planos;
- Regras comerciais configuradas.
Depois disso, a IA gera uma resposta explicando o plano e o valor.
Nesse caso, todas as informações processadas na entrada e a resposta gerada na saída participam do cálculo do consumo.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
IA de Criação de Páginas
A IA de Criação de Páginas utiliza tokens para interpretar o briefing e demais informações fornecidas e, a partir delas, gerar o conteúdo e a estrutura da página.
O que pode ser considerado na entrada?
Briefing;
Prompt e instruções;
Informações do produto ou serviço;
Público-alvo;
Objetivo da página;
Orientações sobre a estrutura;
Outras informações fornecidas para a criação.
O que é considerado na saída?
Podem ser contabilizados os tokens utilizados para gerar:
Copy;
Headlines;
Títulos;
Descrições;
CTAs;
Outros conteúdos gerados pela IA.
Como a criação de uma página pode envolver diversos textos e estruturas, a quantidade de tokens de saída pode ser significativa.
Exemplo:
O usuário solicita:
"Crie uma landing page para uma clínica odontológica que oferece avaliação gratuita para novos pacientes."
A IA pode receber como entrada o briefing, público-alvo, objetivo da campanha e instruções de estrutura.
Como saída, pode gerar:
- Headline;
- Subheadline;
- Benefícios;
- Descrição dos serviços;
- Seção sobre a clínica;
- CTA;
- Textos para diferentes blocos da página.
Nesse caso, o briefing e as instruções entram no cálculo como tokens de entrada, enquanto todo o conteúdo produzido pela IA representa tokens de saída.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
Copilot de Leads
O Copilot de Leads utiliza tokens para analisar os dados dos leads e demais informações disponíveis e gerar respostas ou análises com base na solicitação realizada.
O que pode ser considerado na entrada?
- RAGs;
- Help Center;
- Listas de conhecimento;
- Regras da empresa;
- Produtos IA;
- Documentos do projeto;
- Informações obtidas por ferramentas.
Quanto maior a quantidade de leads e informações utilizadas em uma consulta, maior poderá ser o volume de tokens de entrada.
O que é considerado na saída?
São contabilizados os tokens utilizados para gerar a resposta do Copilot, como:
- Análises;
- Comparações;
- Explicações;
- Resumos;
- Recomendações;
- Outras informações solicitadas pelo usuário.
Exemplo:
O usuário pergunta:
"Quais são os leads com maior potencial de compra?"
O Copilot pode precisar analisar os dados de diversos leads, seus campos, histórico e demais informações disponíveis.
Depois da análise, pode responder:
"Os leads A, B e C apresentam maior potencial porque possuem determinada característica..."
Nesse caso, os dados utilizados para realizar a análise representam tokens de entrada, enquanto a análise produzida pelo Copilot representa tokens de saída.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
Copilot de Time
O Copilot de Time utiliza tokens para interpretar as perguntas dos usuários, consultar as informações disponíveis no projeto e gerar respostas.
O que pode ser considerado na entrada?
- RAGs;
- Help Center;
- Listas de conhecimento;
- Regras da empresa;
- Produtos IA;
- Informações recuperadas pelas ferramentas;
- Outros dados utilizados como contexto.
O que é considerado na saída?
São contabilizados os tokens utilizados para gerar a resposta do agente.
Consultas que exigem análises mais extensas ou respostas detalhadas podem consumir uma quantidade maior de tokens de saída.
Exemplo:
Um usuário pergunta:
"Como funciona o processo de atendimento de um lead interessado em uma demonstração?"
Para responder, o Copilot pode consultar a documentação e as regras disponíveis no projeto.
A resposta gerada pode explicar:
- Como identificar o interesse;
- Quais informações devem ser coletadas;
- Qual etapa deve ser utilizada;
- Quais ações devem ser realizadas posteriormente.
Nesse caso, a pergunta e as informações consultadas são tokens de entrada, enquanto a explicação gerada é composta por tokens de saída.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
Editor de Criativos
O Editor de Criativos utiliza tokens para interpretar as informações fornecidas pelo usuário e gerar os textos e elementos necessários para a criação do criativo.
O que pode ser considerado na entrada?
- Descrição do criativo;
- Briefing;
- Produto ou serviço;
- Público-alvo;
- Informações da campanha;
- Instruções de criação;
- Orientações de layout;
- Textos solicitados;
- Outras informações utilizadas pela IA.
O que é considerado na saída?
Podem ser contabilizados os tokens utilizados para gerar:
- Headlines;
- Textos;
- Chamadas;
- CTAs;
- Estrutura do criativo;
- Elementos textuais;
- Outras informações produzidas pela IA.
Exemplo:
O usuário solicita:
"Crie um criativo para divulgar uma promoção de 20% de desconto em uma loja de roupas."
A IA pode receber como entrada o briefing da campanha, público-alvo, produto e instruções.
Como saída, pode gerar:
- Headline: "20% OFF em toda a loja";
- Texto de apoio;
- Chamada promocional;
- CTA: "Aproveite agora".
Assim, o briefing e as instruções representam tokens de entrada, enquanto os textos criados representam tokens de saída.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
Editor de E-mails
No Editor de E-mails, a cobrança considera as informações utilizadas para orientar a criação e todo o conteúdo produzido pela IA.
O que pode ser considerado na entrada?
- Briefing;
- Instruções;
- Informações do produto ou serviço;
- Público-alvo;
- Objetivo do e-mail;
- Informações de personalização;
- Estrutura desejada;
- Orientações de comunicação;
- Outros dados fornecidos ao modelo.
O que é considerado na saída?
Podem ser contabilizados os tokens utilizados para gerar:
- Assunto;
- Títulos;
- Copy;
- Textos;
- CTAs;
- Estrutura do e-mail;
- Código HTML;
- Outros elementos gerados pela IA.
Como o editor pode gerar tanto o conteúdo textual quanto a estrutura do e-mail, o volume de tokens de saída pode ser significativo.
Exemplo:
O usuário solicita:
"Crie um e-mail para divulgar o lançamento de um novo curso de marketing digital."
A IA pode receber como entrada:
- Informações sobre o curso;
- Público-alvo;
- Objetivo da campanha;
- Tom de comunicação;
- Instruções sobre a estrutura do e-mail.
Como saída, pode gerar:
- Assunto;
- Título;
- Corpo do e-mail;
- Benefícios do curso;
- CTA;
- Estrutura HTML.
Nesse caso, todas as informações enviadas para orientar a criação são consideradas tokens de entrada, enquanto o e-mail produzido pela IA representa tokens de saída.
Cálculo:
Custo = tokens de entrada × preço de entrada + tokens de saída × preço de saída + tokens de cache × preço de cache
Entendendo o impacto do contexto
Uma mesma funcionalidade pode apresentar consumos diferentes entre duas utilizações.
Por exemplo, na IA de Atendimento, uma conversa curta pode utilizar apenas a mensagem atual e algumas instruções. Já uma conversa longa pode exigir o processamento de:
- Dezenas de mensagens anteriores;
- Instruções do agente;
- Documentos;
- Dados do lead;
- Informações de produtos;
- Resultados de ferramentas.
Nesse segundo cenário, a quantidade de tokens de entrada tende a ser maior.
Da mesma forma, uma resposta curta, como:
"Sim, temos esse produto disponível."
Consumirá menos tokens de saída do que uma resposta detalhada explicando características, benefícios, valores e condições do produto.
Portanto, o consumo não depende apenas da quantidade de mensagens ou da quantidade de vezes que a funcionalidade foi utilizada, mas também do volume de informações processadas em cada operação.
Resumo da cobrança
Funcionalidade | Principais informações de entrada | Principais informações de saída |
IA de atendimento | Mensagens, histórico, instruções e contexto | Respostas da IA |
IA de criação de páginas | Briefing, produto, público e instruções | Copy e estrutura da página |
Copilot de leads | Dados dos leads, ferramentas e perguntas | Análises e respostas |
Copilot de time | Documentação, ferramentas e perguntas | Respostas do agente |
Editor de criativos | Briefing, campanha e instruções | Textos e estrutura do criativo |
Editor de e-mail codex | Briefing, produto e instruções | Copy, estrutura e HTML |
Fórmula geral
A cobrança pode ser representada pela seguinte fórmula:
Custo total = Custo de entrada + Custo de saída + Custo de cache
Ou:
Custo total = (Tokens de entrada ÷ 1.000.000 × preço de entrada) + (Tokens de saída ÷ 1.000.000 × preço de saída) + (Tokens de cache ÷ 1.000.000 × preço de cache)
Exemplo de cálculo
Suponha, apenas para ilustrar o funcionamento da fórmula, que uma operação utilize:
- 100.000 tokens de entrada;
- 20.000 tokens de saída;
- 50.000 tokens de cache.
Se o modelo possuir preços hipotéticos de:
- Entrada: US$ 1,00/M tokens;
- Saída: US$ 5,00/M tokens;
- Cache: US$ 0,10/M tokens;
o cálculo seria:
**Entrada:**
100.000 ÷ 1.000.000 × US$ 1,00 = US$ 0,10
**Saída:**
20.000 ÷ 1.000.000 × US$ 5,00 = US$ 0,10
**Cache:**
50.000 ÷ 1.000.000 × US$ 0,10 = US$ 0,005
**Custo total:**
US$ 0,10 + US$ 0,10 + US$ 0,005 = US$ 0,205
Todas as funcionalidades de IA seguem o mesmo princípio: a cobrança é baseada na quantidade de tokens processados pelo modelo e no preço definido para cada tipo de token.
De forma simplificada:
Mais informações enviadas para a IA → mais tokens de entrada.
Respostas maiores ou mais complexas → mais tokens de saída.
Reutilização de contexto em modelos com cache → possível cobrança de tokens de cache.
Por isso, duas utilizações da mesma funcionalidade podem apresentar custos diferentes, mesmo que tenham sido executadas pelo mesmo usuário.